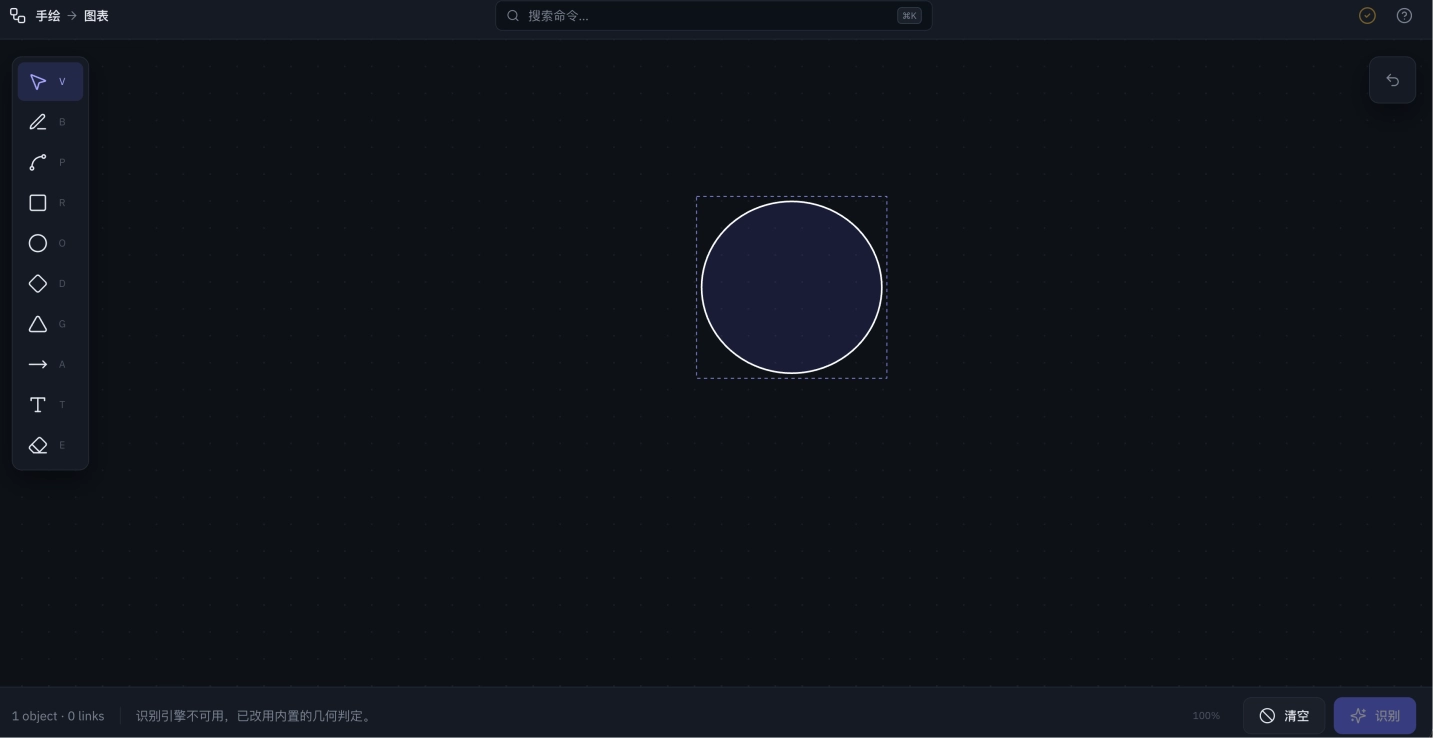
一块深色的无限画布,左侧是画笔、路径、矩形、箭头、文字等工具栏,顶部有命令搜索框。用画笔随手画一个歪歪扭扭的方框、一个圆圈,再画一条箭头把它们连起来,然后点右下角的「识别」——笔迹会被替换成规整的图形和连线,箭头自动吸附到两个节点的边缘,之后还能拖动、缩放、加标签。技术上是 原生 JavaScript 配多层 Canvas,识别部分在浏览器本地运行机器学习模型,不上传任何内容。
这个画板的三个设计
画布分了三层。已确定的图形画在静态层,正在画的那一笔画在实时层,选框和吸附提示画在叠加层,所以画线时只需重绘最上面那一层,图形再多也不卡手。
识别是分级的。先用几何判定试着认出直线、矩形、菱形这些规则形状,认不出来再交给模型;模型没加载好时自动降级到纯几何判定,功能不会中断。
参数全部外置。识别阈值、吸附半径、缩放上下限、配色全收在一个配置文件里,调试时不用翻主逻辑。
把配置和逻辑分开的好处
源码把所有可调项集中成了几组常量,比如识别相关的这一组:
minimumConfidence: 0.3, clusterGap: 26, straightness: 0.06
置信度决定「多像才算认出来」,聚类间距决定多近的笔画算同一个图形,直线度决定一笔要多直才判为直线。这三项直接决定了使用手感——调得太严会经常识别失败,太松又会把随手一划认成矩形。把它们放在一个文件里,意味着调手感是改数值而不是改算法,这对二次开发很友好。
能改的地方
工具栏的条目、命令面板的命令、所有提示文案都在一个数据文件里,增删工具只需加一条记录并补上对应的绘制分支。主题配色是一组色值常量,改成浅色主题只需换这一组。模型地址也在配置里,可以换成自部署的镜像,避免依赖公共 CDN。
常见问题
打开后一直显示「识别引擎加载中」?
识别模型从公共 CDN 下载,首次加载需要联网且体积不小,网络慢时会等较久。完全离线时会自动降级为内置几何判定,方框、圆、菱形、箭头这些仍能识别,只是手写文字识别不可用。页面需通过本地服务器打开。
能识别手写中文吗?
内置的手写识别模型是面向英文的,中文识别效果有限。需要中文手写识别的话,要替换成支持中文的模型并相应调整预处理,图形识别部分不受影响。
画的图能导出吗?
识别后的图形以结构化数据保存在内存里,包含节点类型、坐标和连线关系,序列化成 JSON 即可导出或存到后端,这也是接入自己系统最省力的切入点。
适合用在哪
在线白板与流程图工具、产品原型演示、教学与头脑风暴场景,也适合当作「浏览器端跑机器学习模型」的完整参考实现。分层画布、分级识别与配置外置的完整代码都在源码里,下载后可查看。